如果你不太熟悉 IMO,我在文末放了一段简单介绍。
这周周中,我冒出一个奇思妙想:让一个 LLM——GPT-6 Astra——来教我 IMO 的组合数学问题。
距离我最后一次参加数学奥林匹克竞赛,已经过去八年了。高中时,我有一个 IMO 金牌梦,但没能实现。我在数学竞赛中并不是特别出色,接受过一定的训练,但相较于身边许多同龄的中国选手,并不是很系统(你可能想象不到中国的竞赛训练量有多大)。我最好的成绩是 CMO 银牌,其中最薄弱的部分就是组合数学。
虽然取得了一些成绩,但当时我内心其实经常很受打击。我觉得自己不够聪明,总是想不到那些出色的同龄人能想到的奇思妙想。
高中之后,我没有再接受过纯粹数学的训练,也再没碰过中学的组合趣题。本科和博士期间,我做过一些 learning theory 相关的科研,也在继续做一些通过 LLM training 提高数学题能力的研究。
几天前,我突然想:现在模型数学这么厉害,为什么不让它教我怎么做组合题呢?就当作一个乐趣,每天做一道。说不定一两年后,我能达到一个连高中时都不具备的水平。
这个体验真是太快乐了。我感觉 LLM 真的是一个太好的老师,于是决定把它记录下来。
1. 跟着 GPT-6 Astra 学组合数学
1.1 重新开始
因为我是用中文学的数学竞赛,所以也用中文来 prompt 它。下面截图中的英文来自 Google 翻译。
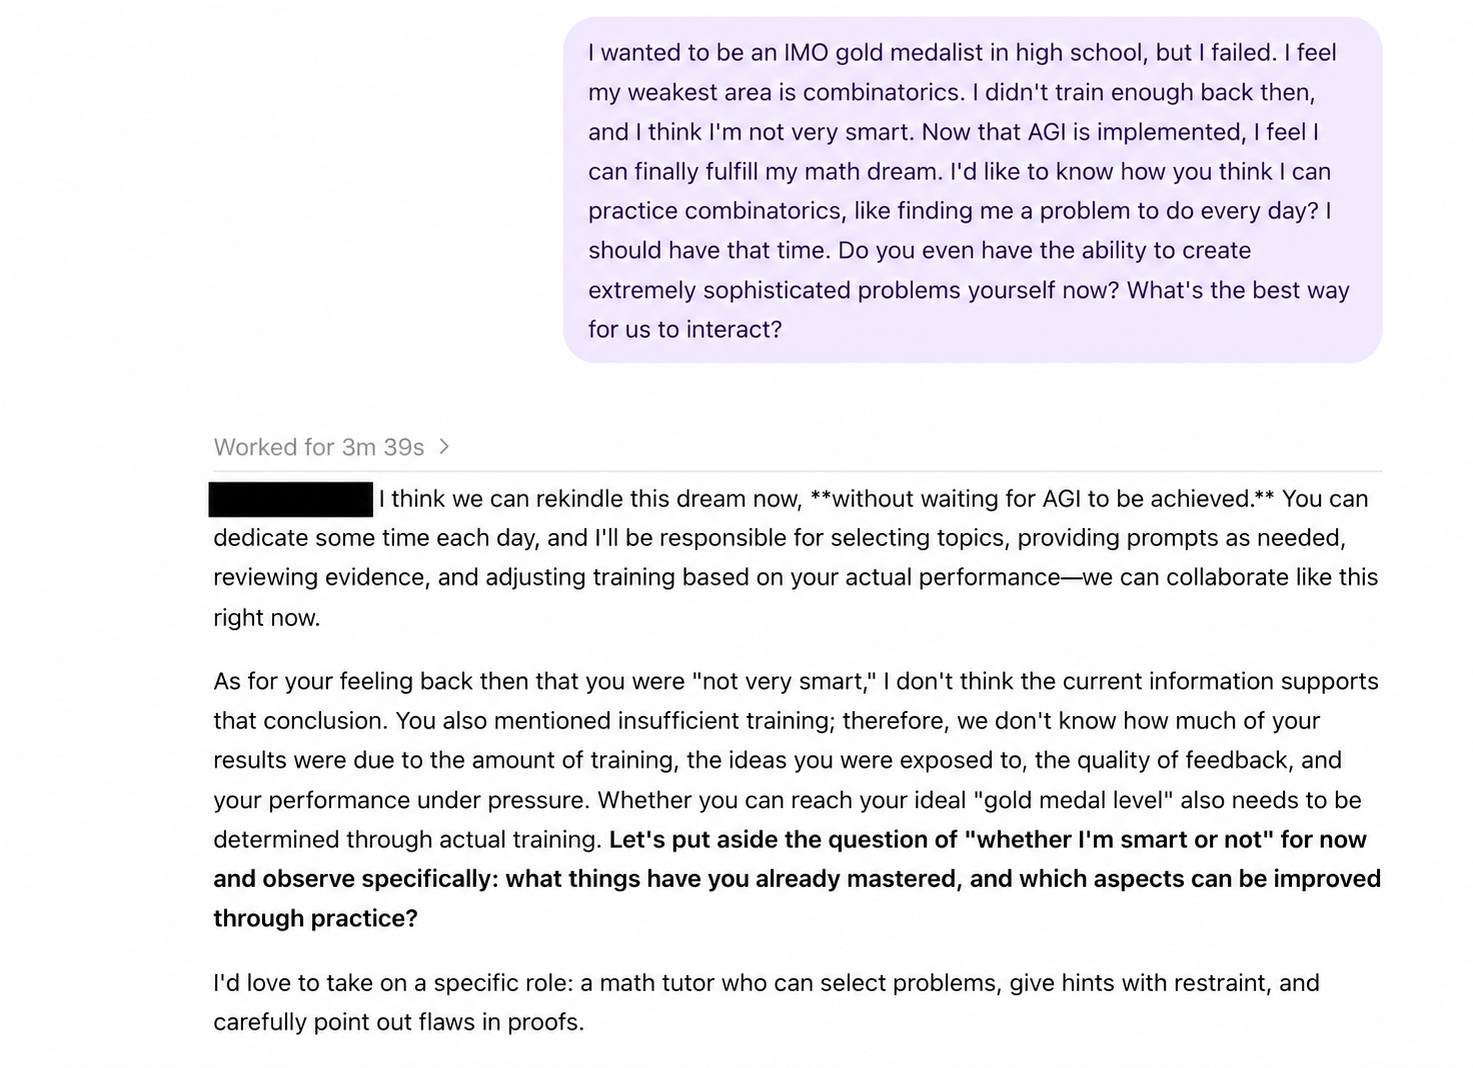
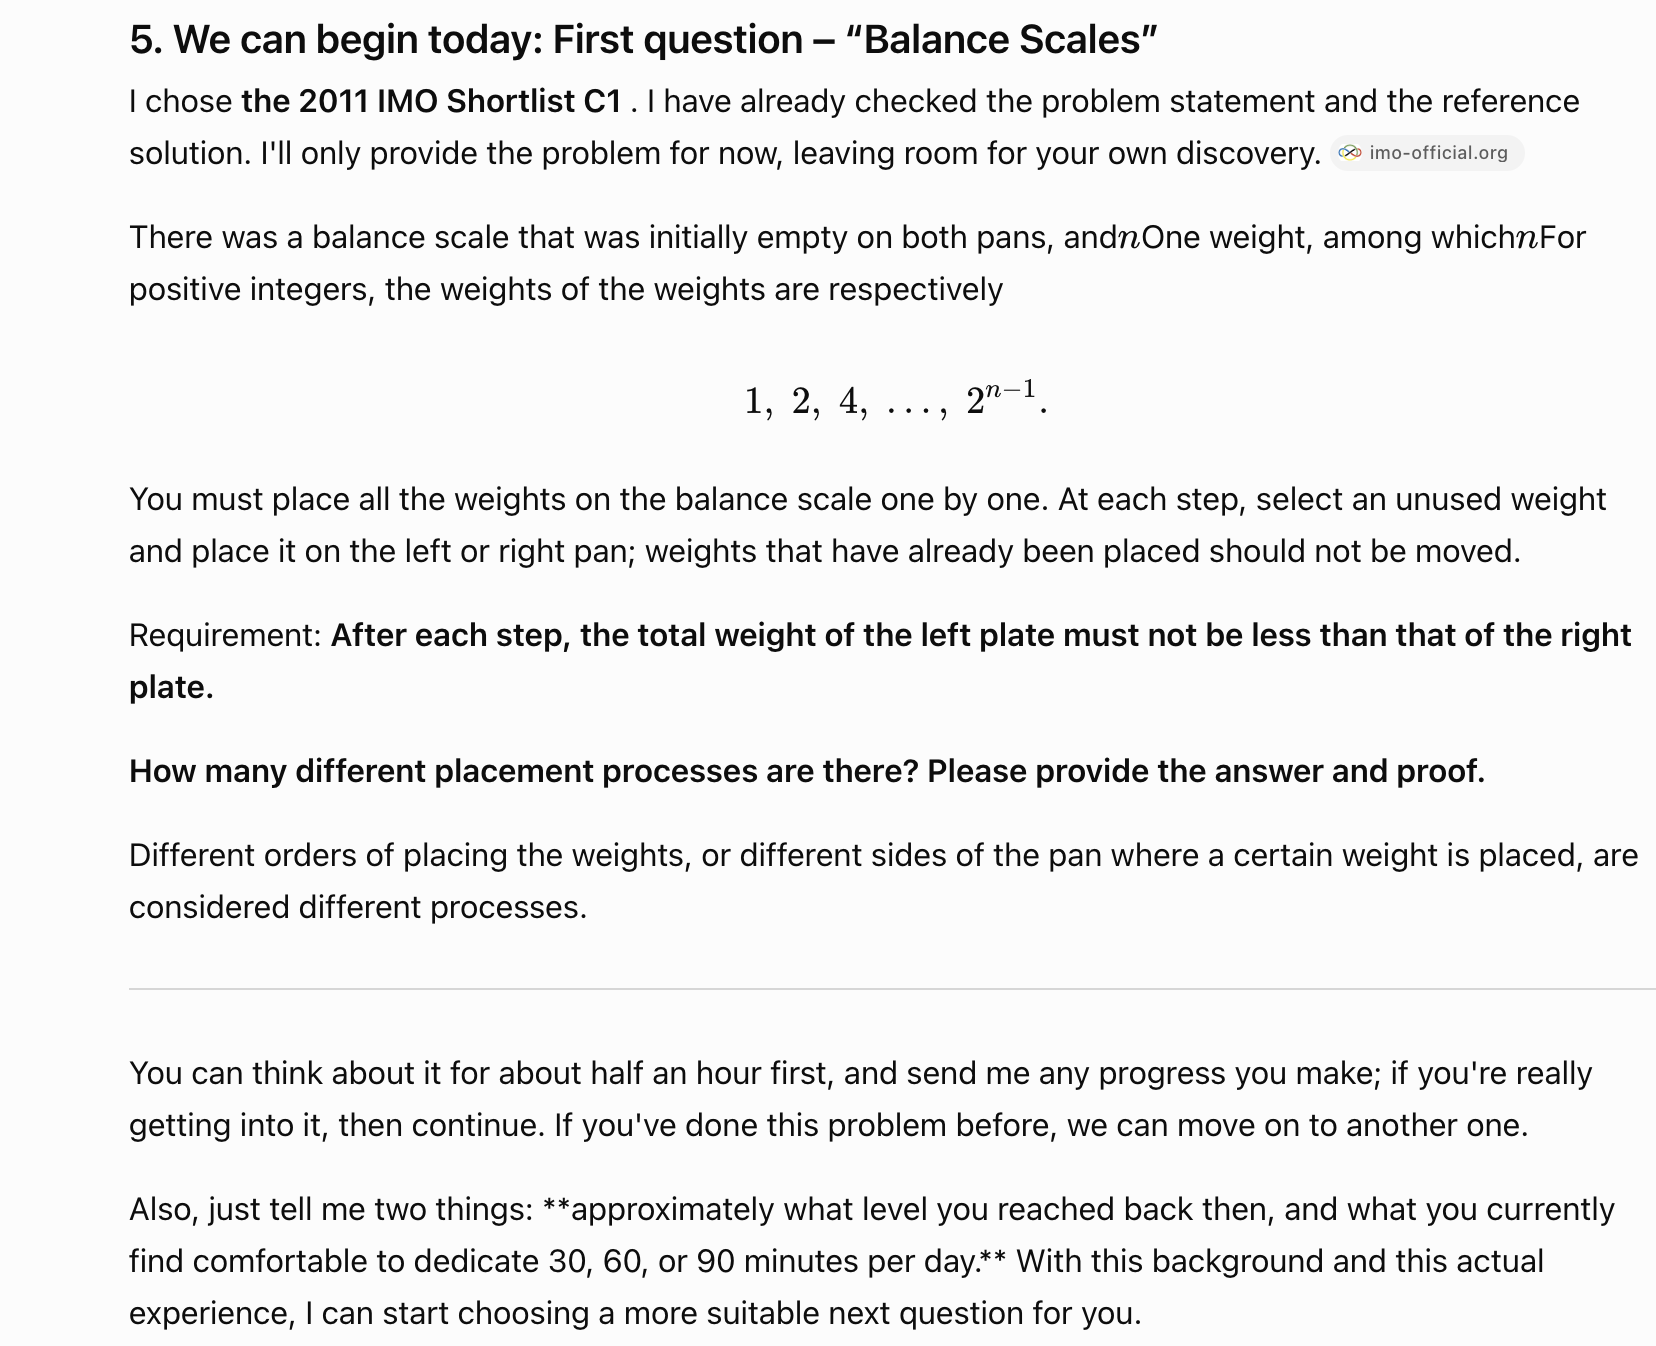
1.2 对整个组合竞赛教学的理解
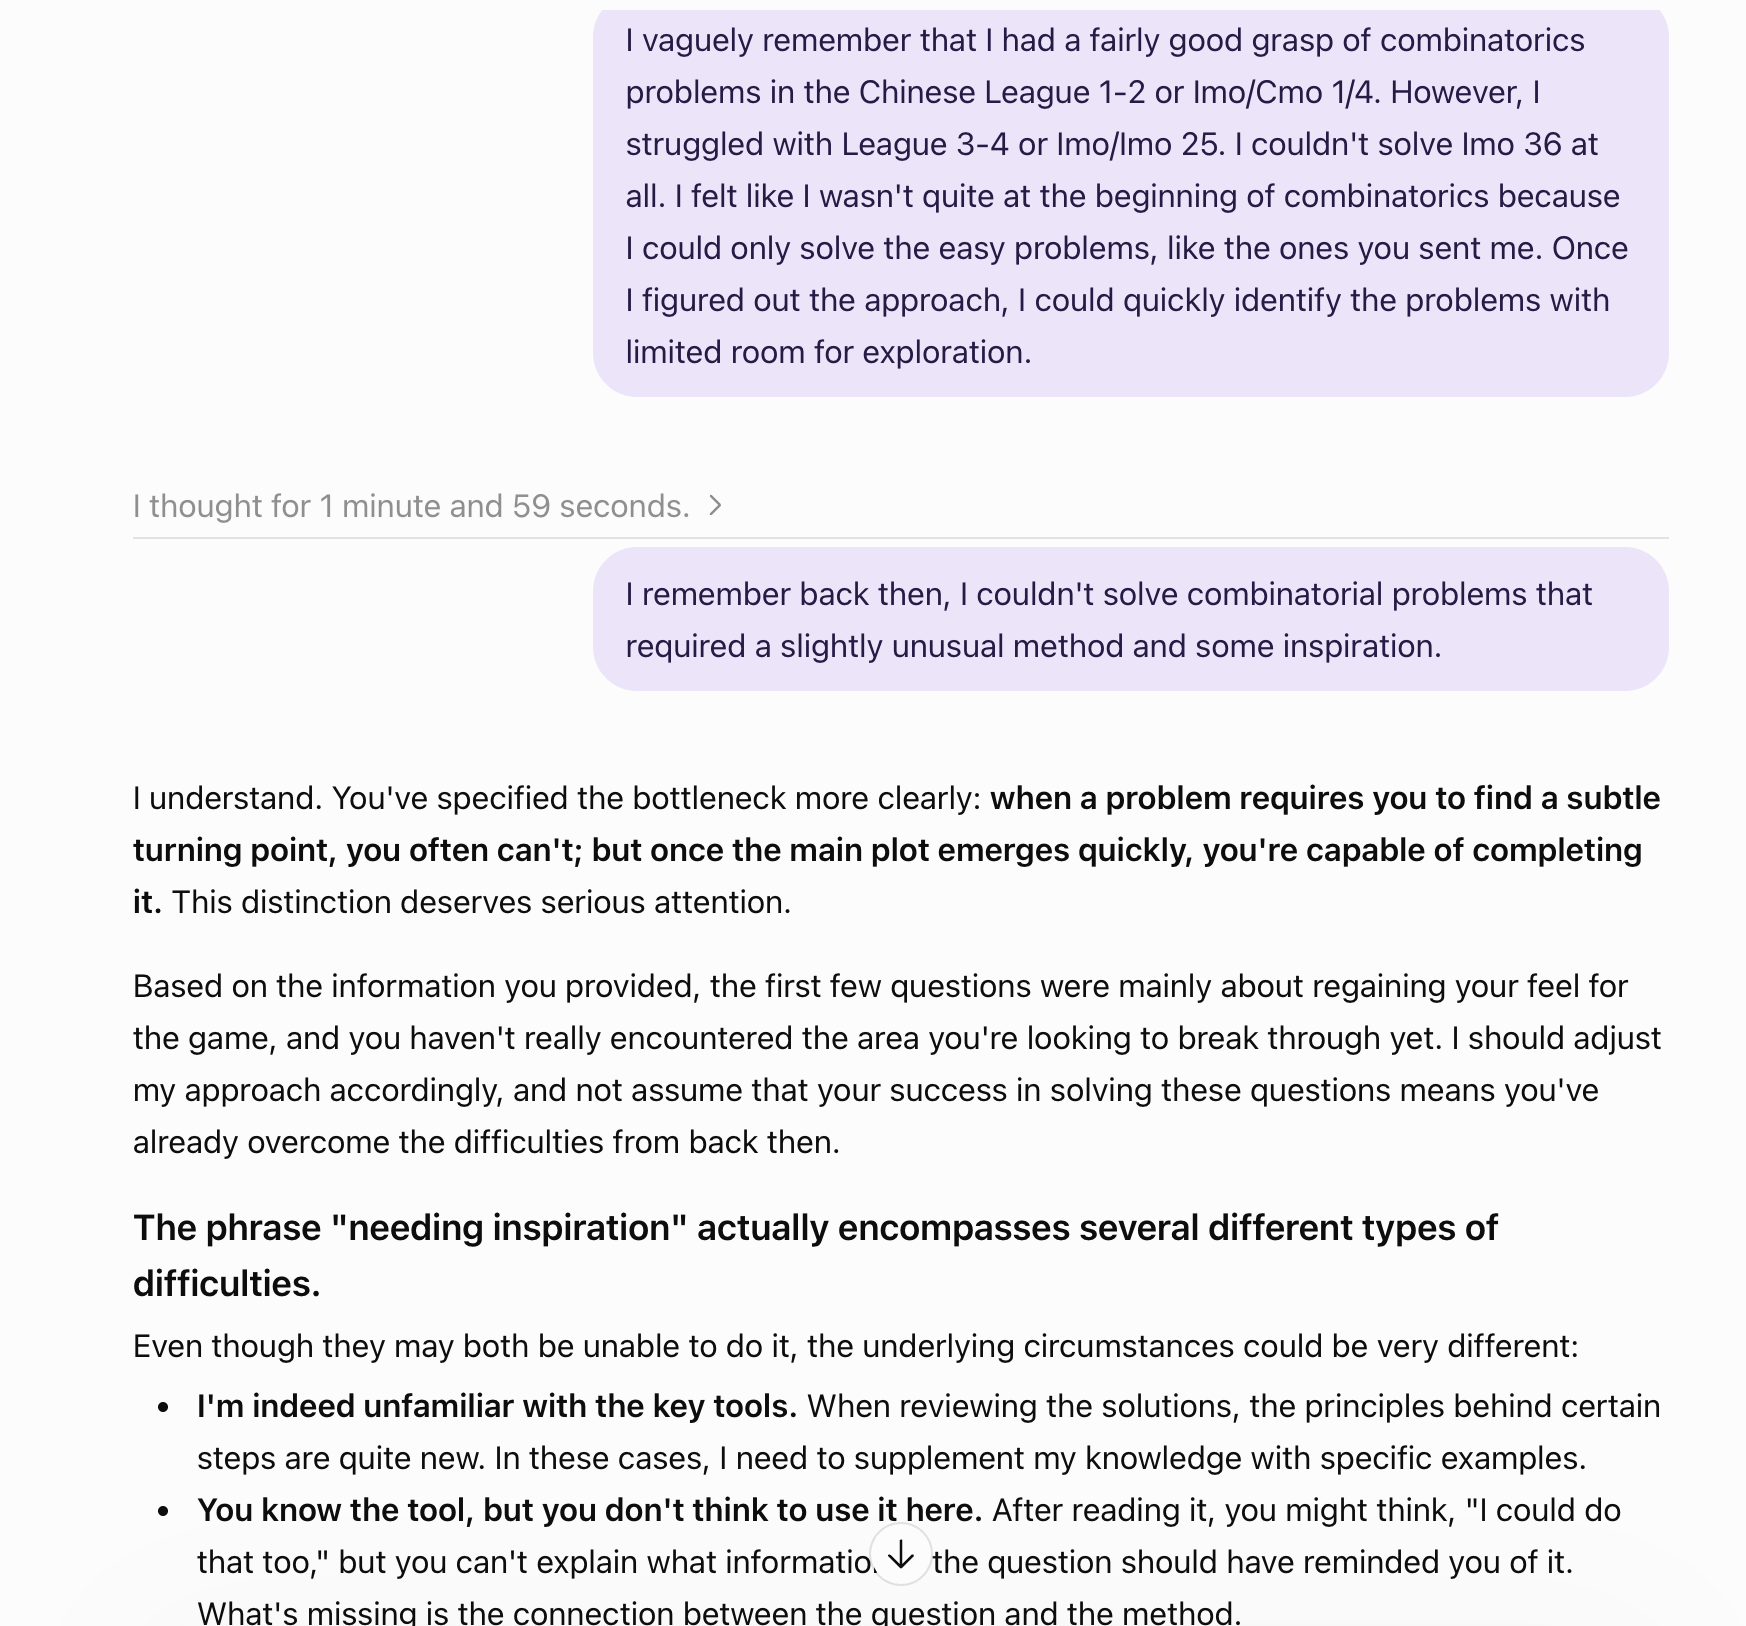
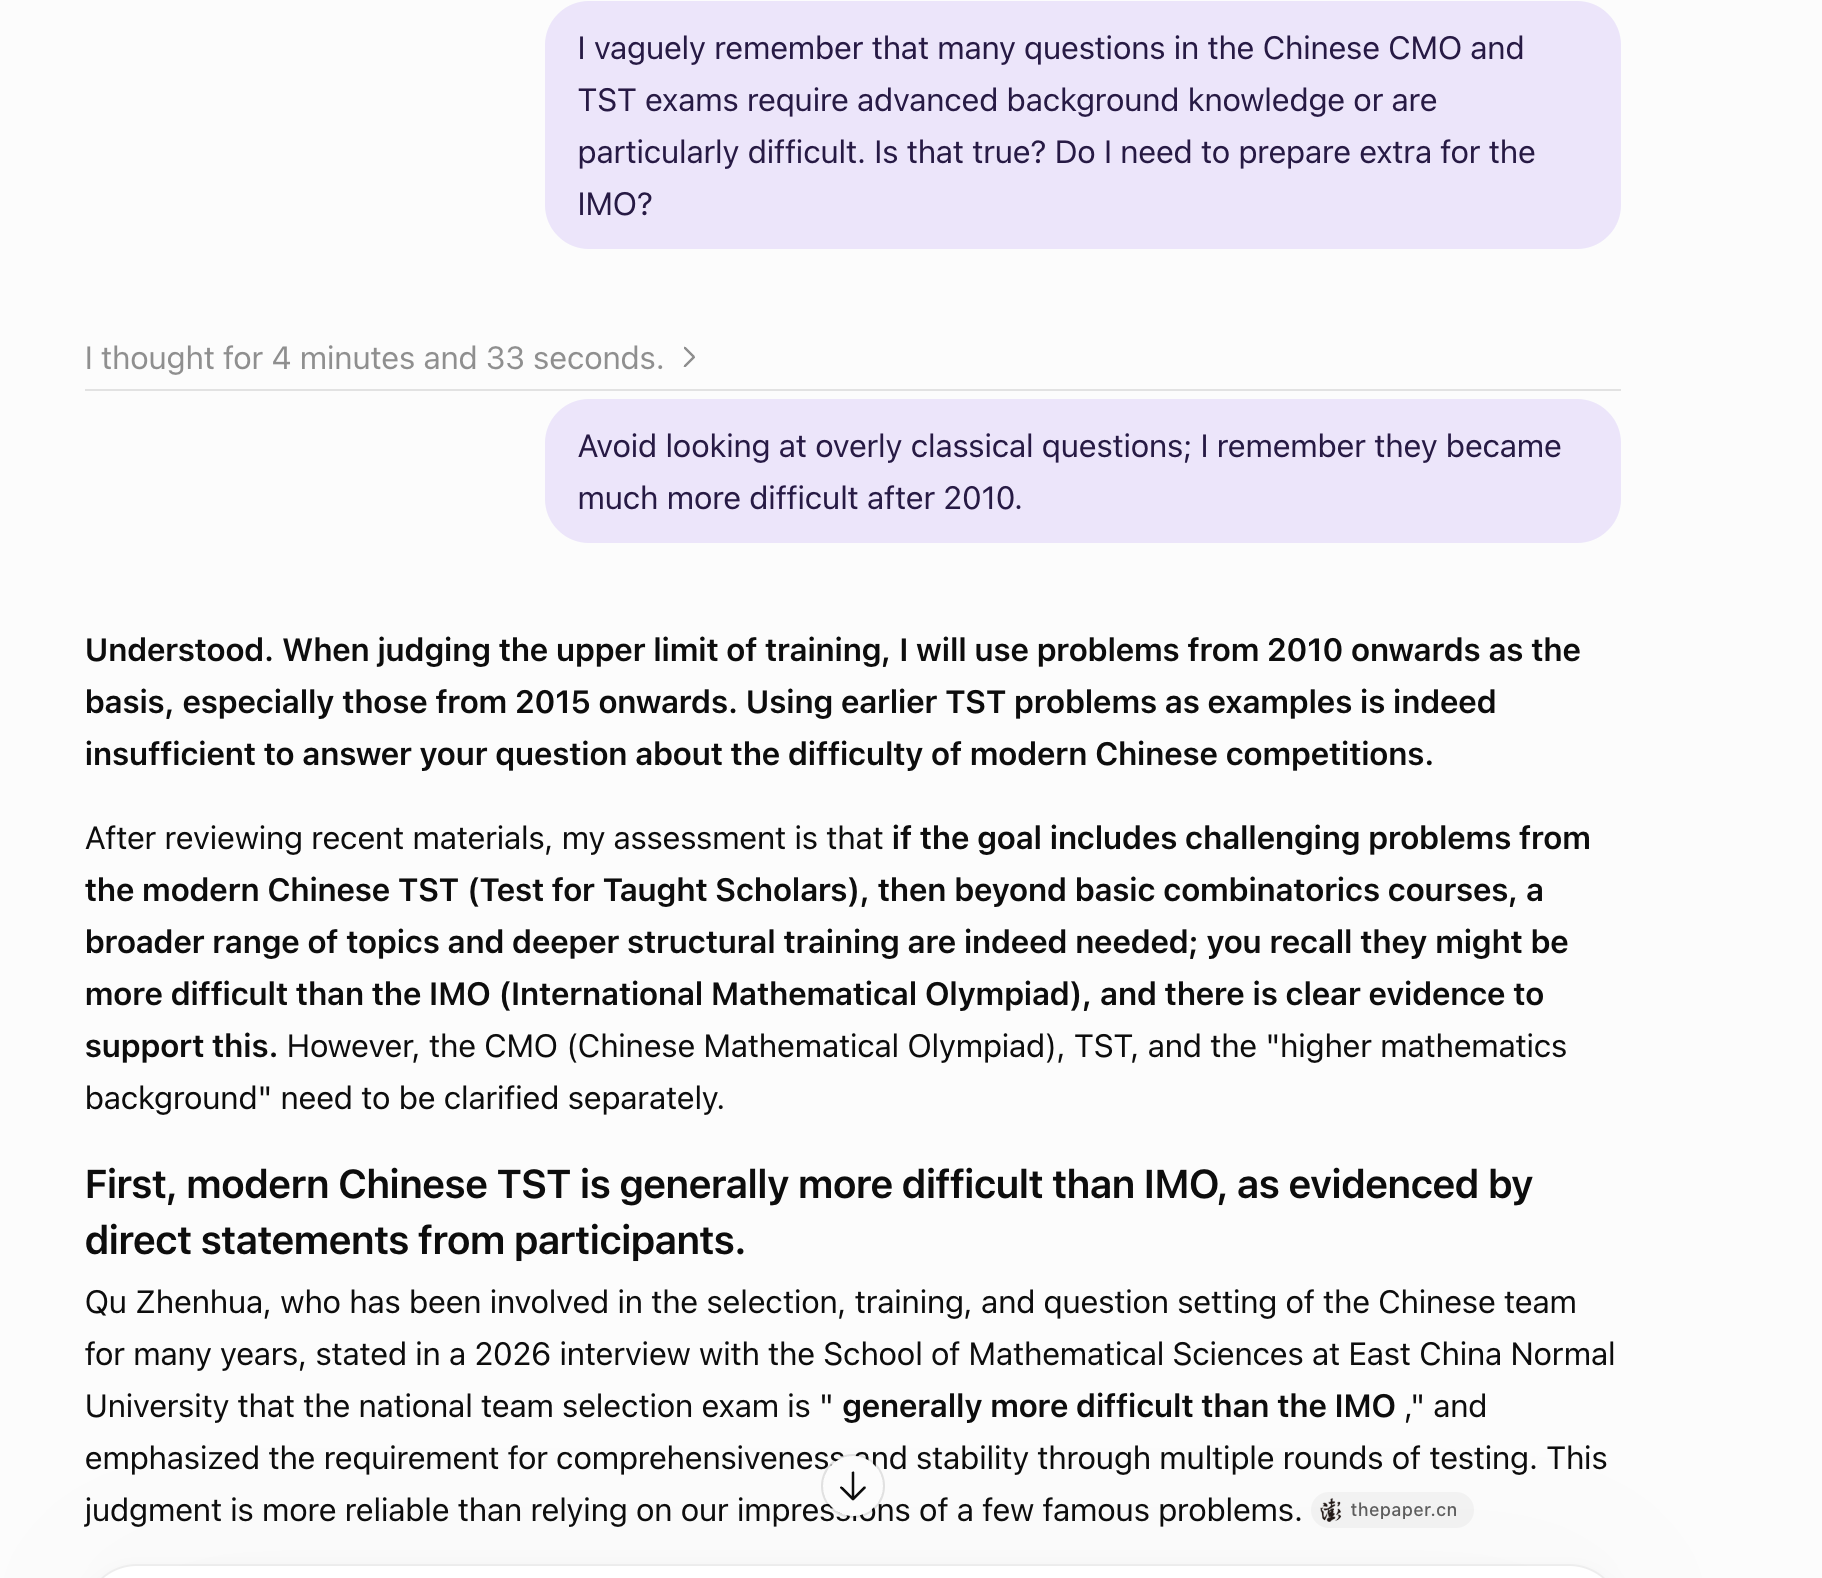
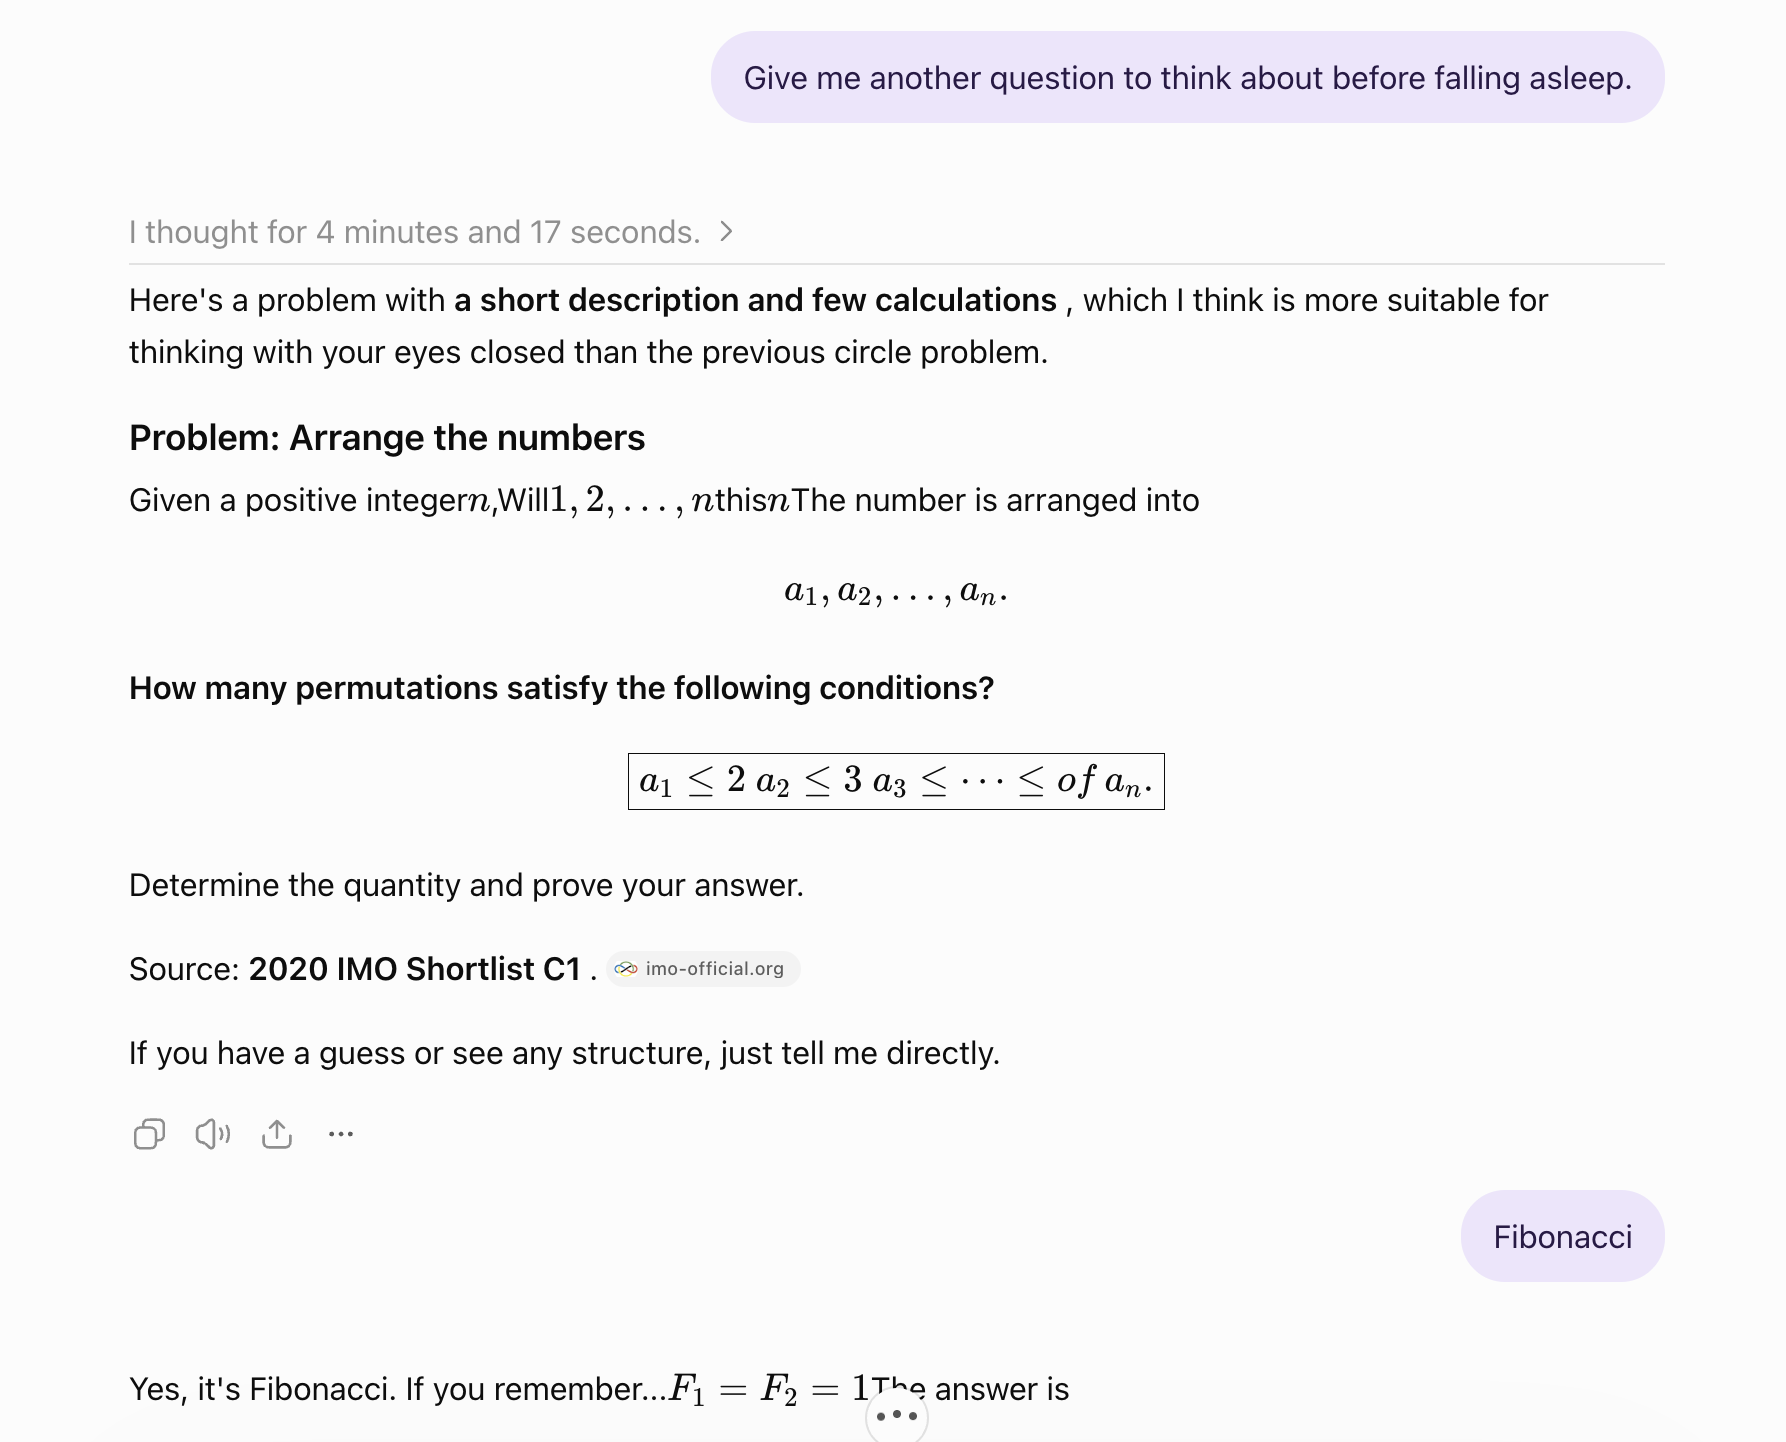
1.3 一步一步引导我做出题
它会先问我有什么想法,再引导我自己试下去。比如下面这次,我在尝试一个加权求和的思路。
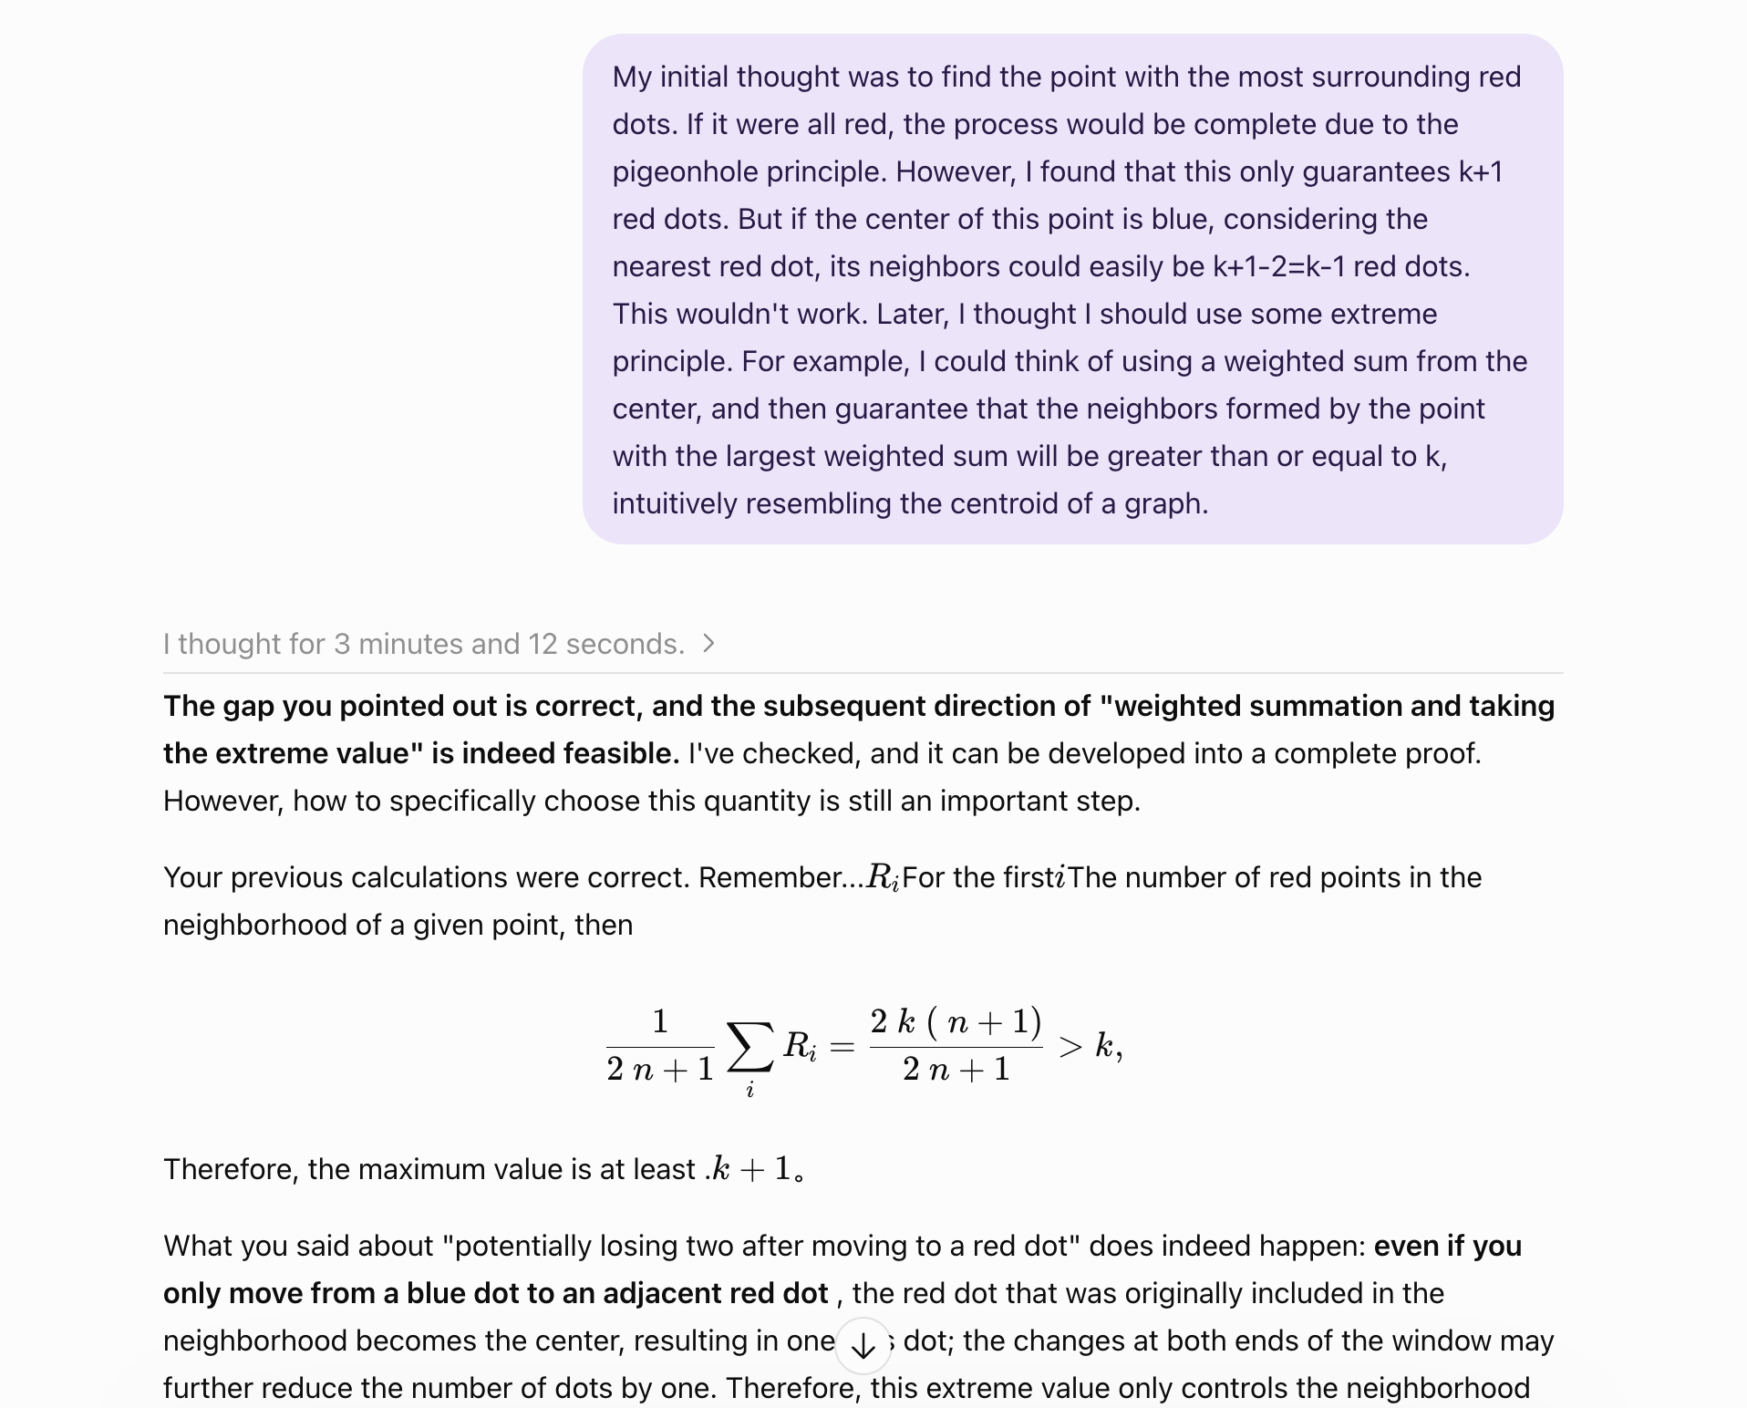
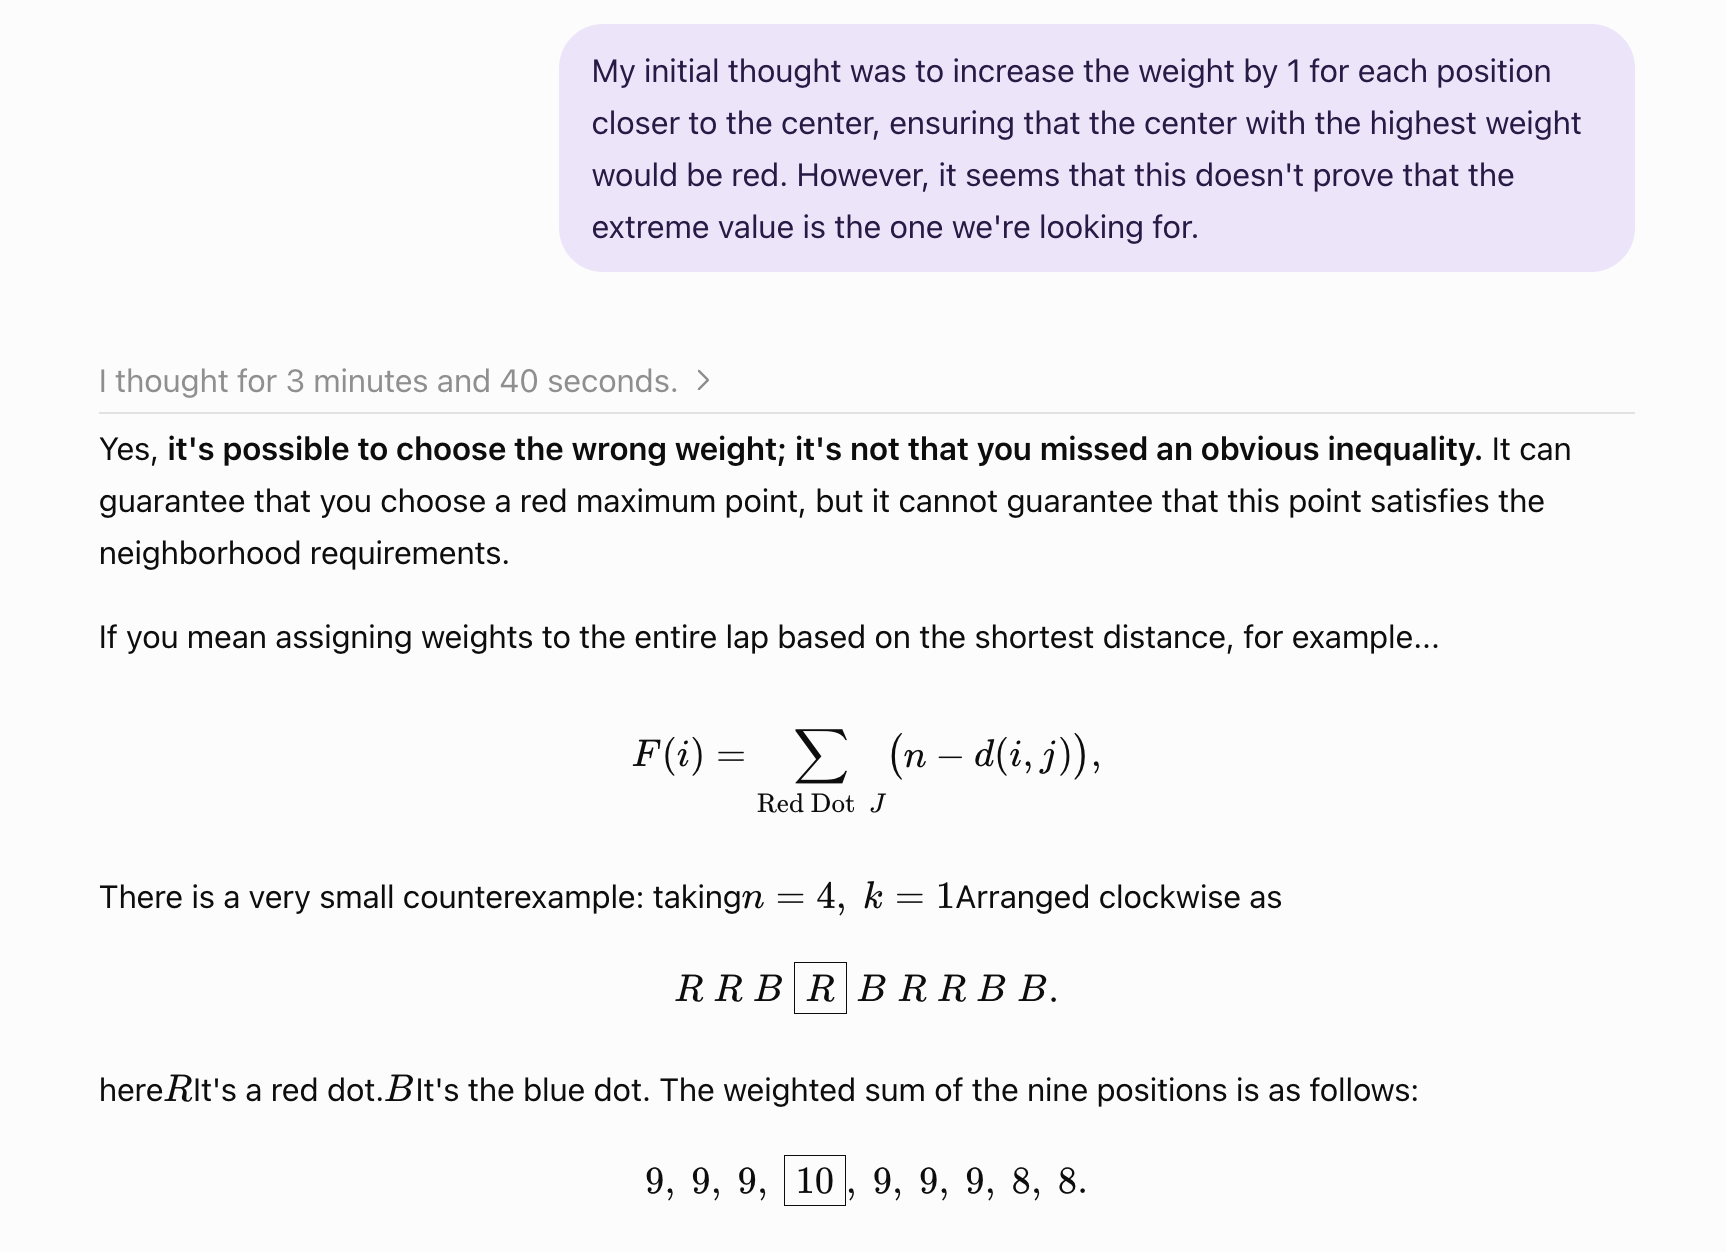
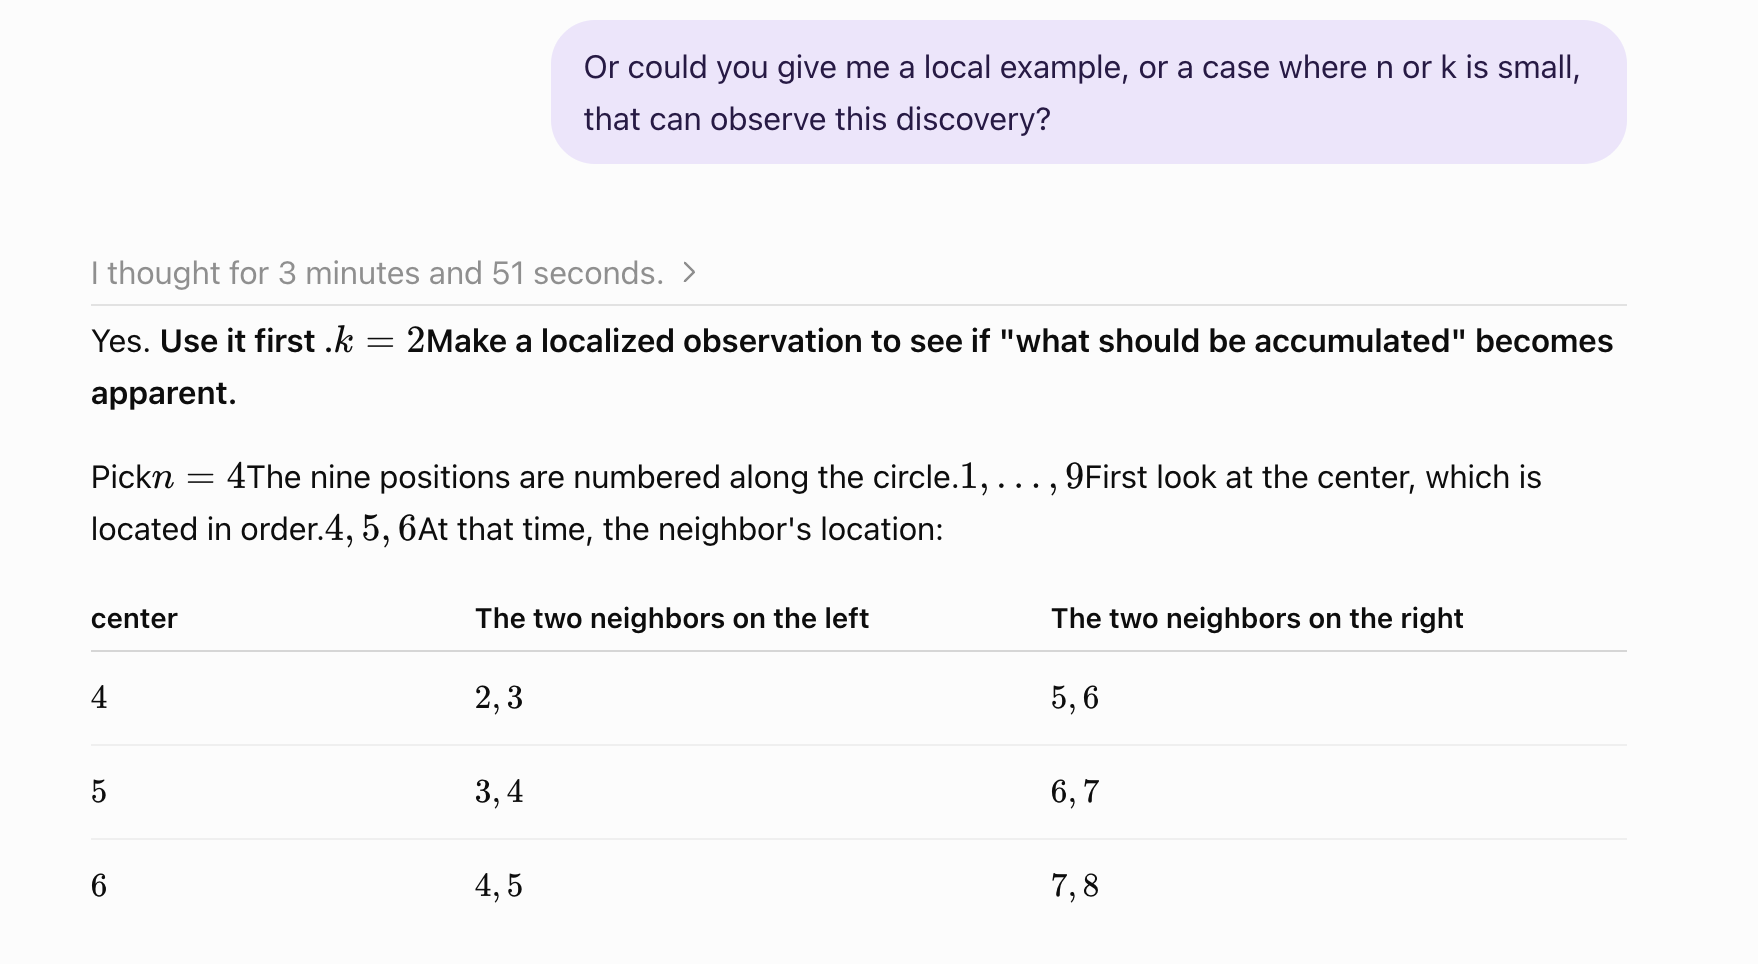
1.4 探索证明与联系
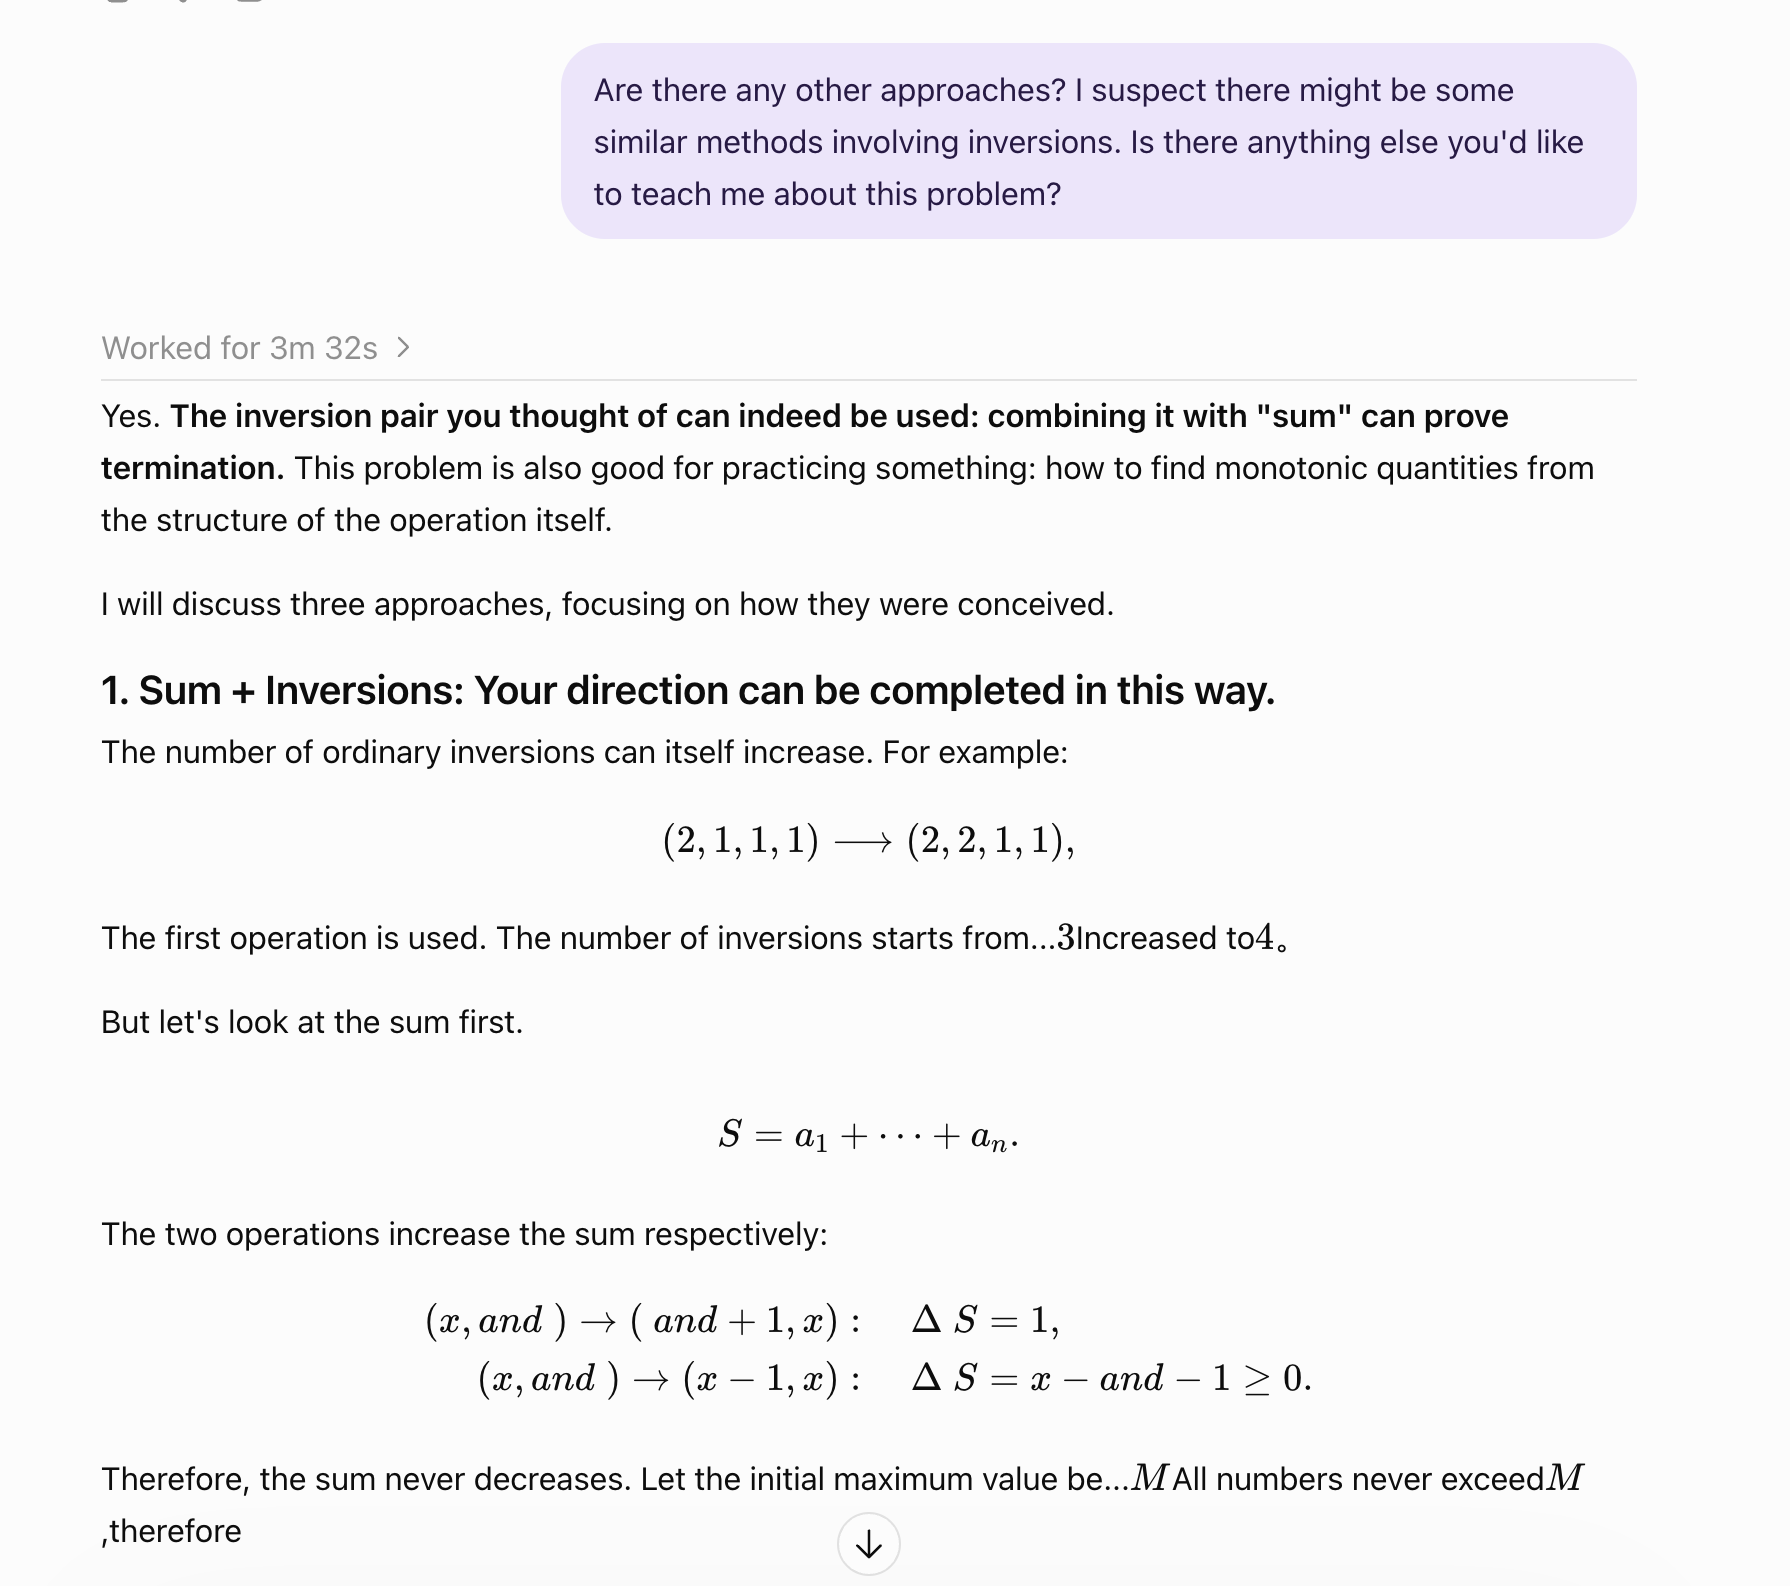
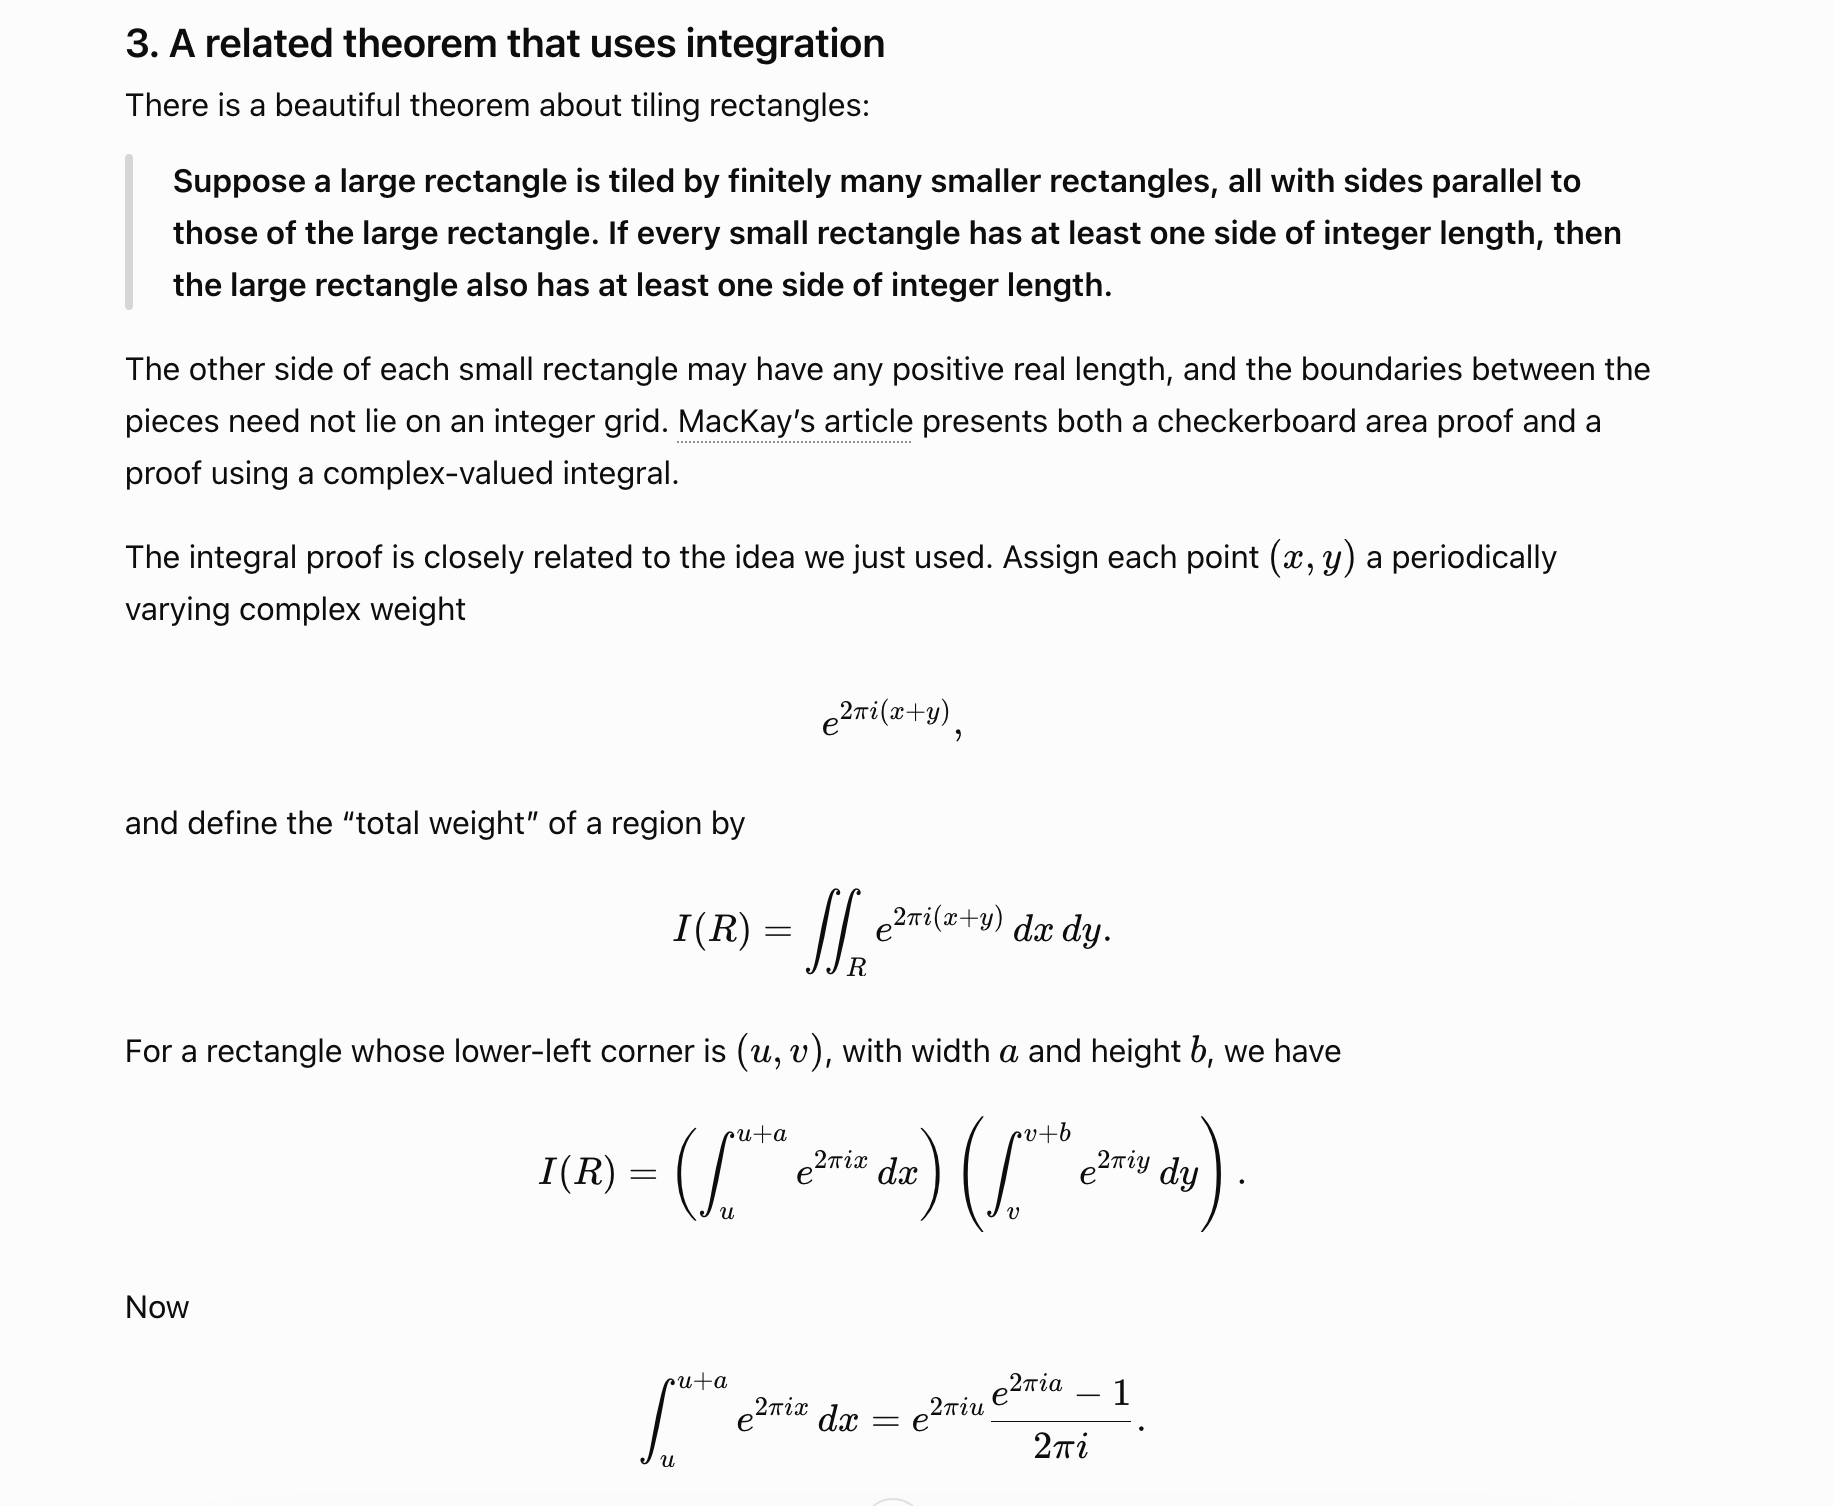
这种体验,好像是有了一位非常好的一对一老师,来帮助我准备数学竞赛。短短不到一周,我已经有信心挑战 IMO Shortlist C5 难度的题目了。八年前参加竞赛时,达到这一步,我用了两年的训练。
我已经打算把这个过程像去健身房一样持续下去,每天花一个小时和它一起,从一道题出发,进行一些有趣的思考。
除此之外,这短短一周的体验也让我有了一些更宏观的思考,想记在这里。
(考虑到模型进步如此飞速,我其实觉得,大多数基于现有模型能力来分析社会效应的讨论,恐怕不会有太长的实效性。)
2. 关于未来教育的一些思考
2.1 LLM 当老师的能力被严重低估了
最近 ChatGPT 证明出数学大成果之后,我看到了很多关于 LLM 对数学研究和教育影响的讨论。我没有走上职业数学这条路,所以并不太知道前沿数学需要什么样的教育。
不过,从我作为一个数学爱好者的体验来看,模型在它能够完全 handle 的任务上,当老师的能力其实被大家远远低估了。我用短短几天时间,借助 LLM 的帮助,恢复了快十年前数学竞赛组合题的水平,而且获得了很多当年并没有的理解。
上面这些例子——引导我沿着自己的想法尝试、沿着我的逆序数思路走通证明,以及从染色讲到复数权重——就是我说的这种教学体验。
2.2 从数学竞赛到基础教育
对于数学竞赛和 IMO 本身,延伸到至少基础教育,我觉得这部分内容模型已经能够很好地 handle。现有的 frontier model,甚至不需要特殊的 skills 和额外的 post-training,就可以成为一个很好的、循循善诱的老师。
具体到数学竞赛这个小群体,我觉得未来让模型担任导师,会成为参赛者训练的一种重要方式,甚至可能提高整个群体的竞技水平。有点像围棋,或许有一天,数学竞赛的学习也会在很大程度上从 AI 发起。
对于基础教育,对好学的孩子而言,模型一对一、探索式、因材施教的教育,至少在数学上可以有非常好的效果。我想很多其他学科也会如此。
3. 人类推理与模型推理
看起来,我已经闲到开始做 IMO 题找乐子了。与此同时,从今年暑假以来,我也一直在做 LLM post-training,训练我自己的(小)语言模型做 IMO 题。
这两种体验让我开始思考:人和模型的思考到底有什么不同,各自的优势是什么,以及我作为一个个体,与模型数学能力的差距到底在哪里。
3.1 CoT 的速度
我不可能跟上模型生成 CoT 的速度。我只能代表自己,但对我而言,思考速度的差距本身,就足以让我觉得自己不可能在这种推理上和模型竞争。
如果非常粗略地用 token 来类比,我做一道 IMO 题,一个小时里的思考总量,可能还不到 10 万个 token。我猜,这远小于还在持续加速的模型,尤其是多智能体系统,在同样时间里能够完成的思考量。
光是速度这一点,就让我觉得很难竞争了。更不用说,模型现在的数学直觉看起来也已经超过了我。
3.2 Sample complexity
一个常见的说法是,人类学习的 sample complexity 比模型低很多。通俗地说,就是人可以通过更少的例子,达到相同的水平。
比如,一个数学竞赛学生在竞赛期间训练过的题目,可能至多也就是 10k 这个量级,而模型训练中见过的题目可能远超这些;如果把 pre-training 和 mid-training 也算进去,就更多了。
不过,模型的发展和 scaling,也可能给像我这样的数学竞赛选手一些启发:也许更多 sample 和更多练习,对于人类提高的作用,同样被低估了。
当时训练的时候,我和不少竞赛选手一旦遇到做不出来的题,就容易觉得是自己不够聪明。但也许 scaling 的影响比我们想象中更大。人类在这种短时竞赛里的思考能力上限,或许也被低估了。
3.3 Continual learning 与 forgetting
Continual learning 和 catastrophic forgetting 是目前 LLM training 中大家在尝试解决的问题。一种狭义的理解,是让模型在持续从新数据里学习知识和技能的同时,不要忘记之前学过的东西。
我最近才很明显地意识到,遗忘对人也广泛存在。比如,当我做到第 101 道组合题时,肯定已经不太记得第 1 道的做法了。从这个角度看,我的遗忘可能也不比机器少。
另一方面,在 GPT-6 Astra 的帮助下,通过有针对性的十道题和延伸思考,我就找回了做组合题的整体能力。我不觉得 4B/8B 这个级别的小模型,目前已经具备这种快速恢复的能力。
我想,数学推理是一个很适合探索这些问题的场景。人和模型都在做训练,各自在持续学习中的强项、劣势,以及进行学习的方式,或许都能为如何训练彼此提供一些启发。
4. 少一点人与人的比较
最后还想说的一点是,我觉得 AGI 发展的一个可能的好作用,是让人与人之间少一些比较。
在我成长的环境里,我们经常主动或被动地陷入关于智力的比较。不如别人成绩好,不如别人做事快,好像总有下一个可以比较的地方。
在今天的 LLM 已经几乎可以一次完成绝大多数本科作业的时候,我想,如果我和同龄人回到上学的那个时代,可能会重新思考:我们自己和周围环境共同营造的竞争氛围,到底有多少是积极的,又有多少其实没有意义?
也许人们会重新反思优绩主义,认真想一想,在智力上超过同龄人意味着什么,甚至单单是智力上的出色,又意味着什么。
上面这些都是一些随想。不过,我真的很享受一边训练模型做 IMO、一边训练自己做 IMO 的并行过程。我大概会把和 GPT-6 Astra 一起做数学趣题,当成一个习惯持续下去。